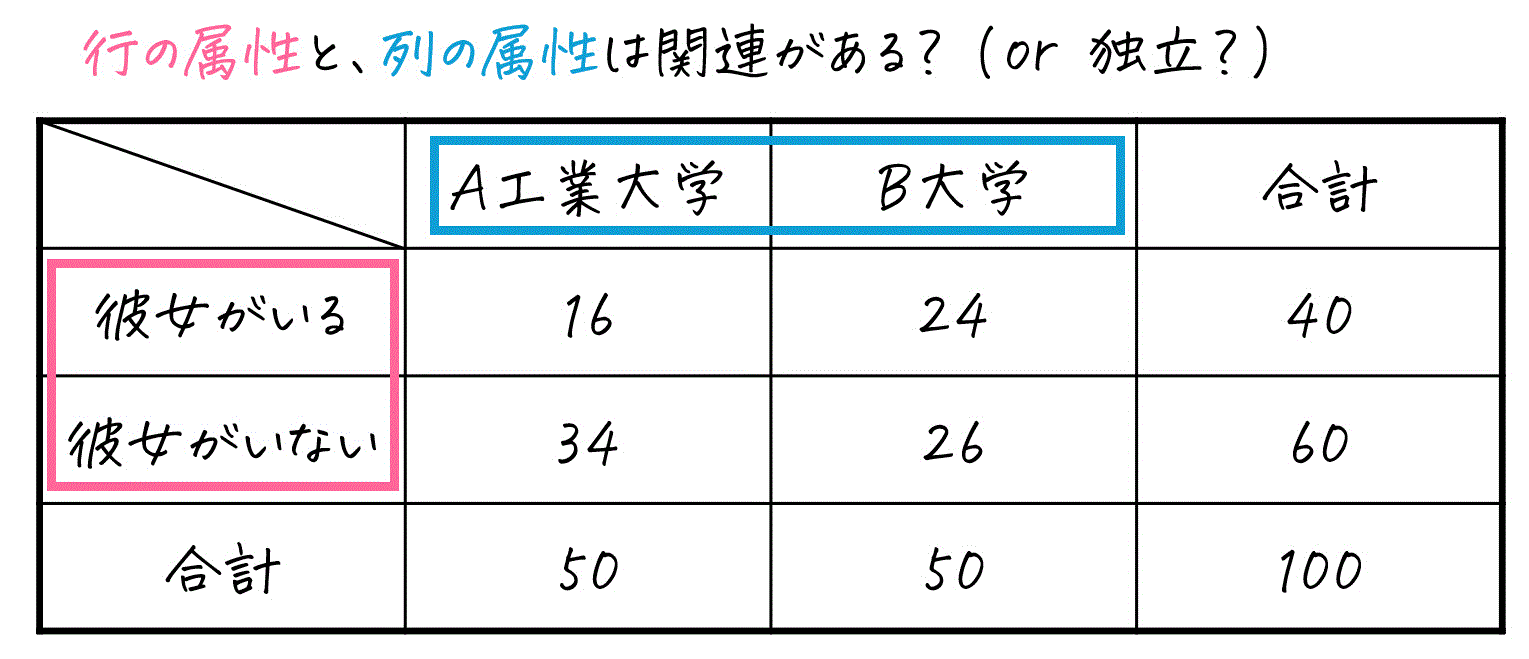
観測度数のクロス集計表を作成(2x2配列)
データ分析やマーケティングリサーチ、卒論の執筆において「2つの要素に関連があるか確かめたい」「アンケート結果の偏りを客観的に証明したい」という場面に直面したとき、最も強力な武器となるのがカイ二乗検定($\chi^2$検定)です。しかし、数式の複雑さや「期待度数」「自由度」「p値」といった専門用語の壁に阻まれ、挫折してしまう学習者も少なくありません。
本稿では、統計学の初学者でも直感的に理解できるよう、カイ二乗検定の基本概念から「独立性の検定」「適合度検定」の明確な違い、実務で即役立つエクセル計算やPythonによる実装手順までを網羅しました。現場で頻発する「有意差なし」の解釈ミスやサンプルサイズの罠を回避し、数字に裏打ちされた正しい意思決定を行うための実践的知見をお届けします。
📌 【この記事の重要ポイントまとめ】
- 要点1:カイ二乗検定は「観測されたデータのズレ」が偶然か必然かを判定する手法であり、2大分類(独立性の検定・適合度検定)を用途に合わせて正しく選ぶことが不可欠。
- 要点2:エクセルでは「CHISQ.TEST関数」を使えば一瞬でp値を算出可能だが、前提となる「期待度数」と「自由度」の計算ロジックを押さえないと解釈ミスを招く。
- 要点3:「p値 > 0.05(有意差なし)」は「関連がない証明」ではなく「サンプル不足の可能性」を疑うべきであり、適切なサンプルサイズ基準(各セル期待度数5以上)の遵守が必須。
【基本解説】カイ二乗検定とは?初心者が最短で直感理解する仕組み
カイ二乗検定とは、アンケートや実験などで得られた「カテゴリごとの頻度(カウントデータ)」に対して、「理論上の予測値(期待度数)」と「実際に観測された値(観測度数)」の間に統計的なズレがあるかを検証する手法です。
たとえば、「新デザインのWebサイトにリニューアルしたところ、男性の購入率が上がったように見える」というケースを考えてみます。単なる偶然のブレなのか、それとも「性別とデザインの好みに明確な関連がある」と言えるのか。この曖昧な感覚を客観的な数値基準で白黒つけるのがカイ二乗検定の役割です。
検定のコアとなるカイ二乗値($\chi^2$)の計算式は以下の通り極めてシンプルです。
$\chi^2 = \sum \frac{(O - E)^2}{E}$
($O$:観測度数 Observed、$E$:期待度数 Expected)
「実際のデータ($O$)から理論値($E$)を引き、それを2乗して理論値($E$)で割る」。各枠(セル)でこの計算を行い、すべて足し合わせた合計が「カイ二乗値」となります。ズレが大きければ大きいほどカイ二乗値は跳ね上がり、p値が小さくなって「偶然とは考えにくい(有意差あり)」という判定が下されます。
【違いを整理】「独立性の検定」と「適合度検定」の決定的な使い分け
カイ二乗検定で初心者が最初につまずくのが、「独立性の検定」と「適合度検定」の混同です。両者は分析の目的と入力するデータの構造が根本的に異なります。
| 項目 | 独立性の検定(Test for Independence) | 適合度検定(Goodness-of-Fit Test) | 編集部の見解・実務上の着眼点 |
|---|---|---|---|
| 検証したい仮説 | 2つの変数(例:年代と商品選好)に関連・関連性があるか | 1つの変数の分布が、理論比率(例:メンデルの法則・均等比率)と合致するか | ビジネス実務の9割以上は「独立性の検定」を使用 |
| データ形式 | 2次元のクロス集計表(行 $\times$ 列) | 1次元の度数分布表(1列または1行) | クロス表を作ったら迷わず独立性の検定を選択 |
| 自由度($df$)の求め方 | $(行数 - 1) \times (列数 - 1)$ | $カテゴリー数 - 1$ | $2 \times 2$の分割表なら自由度は必ず「1」になる |
| 典型例 | 「性別によって有料プラン登録率に差があるか?」 | 「サイコロを600回振って各目が100回ずつ均等に出るか?」 | 理論値が自明な場合は適合度、データから探る場合は独立性 |
【実践ステップ】クロス集計表の期待度数・自由度・p値の計算手順
実務で頻出する「$2 \times 2$のクロス集計表」をもとに、手計算および理論上のプロセスを追いかけます。
ステップ1:クロス集計表の作成と期待度数の計算
ある施策で「メルマガA」「メルマガB」をそれぞれ100名に配信し、クリック数を集計したとします。
- メルマガA:クリックした 30名 / クリックなし 70名(計100名)
- メルマガB:クリックした 10名 / クリックなし 90名(計100名)
- 全体合計:クリックした 40名 / クリックなし 160名(全体200名)
このときの期待度数(もしメルマガの種類に関係なくクリック率が均等だった場合の理論値)は、以下の計算式で各セルごとに求めます。
期待度数 =(そのセルの行合計 $\times$ そのセルの列合計)$\div$ 全体総数
メルマガA・クリックありの期待度数は $(100 \times 40) \div 200 = \mathbf{20}$ となります。同様に計算すると、4つのセルの期待度数はそれぞれ $[20, 80, 20, 80]$ と算出されます。
ステップ2:カイ二乗値と自由度の算出
各セルの $(O - E)^2 \div E$ を合計します。
- A・あり:$(30 - 20)^2 \div 20 = 100 \div 20 = 5.0$
- A・なし:$(70 - 80)^2 \div 80 = 100 \div 80 = 1.25$
- B・あり:$(10 - 20)^2 \div 20 = 100 \div 20 = 5.0$
- B・なし:$(90 - 80)^2 \div 80 = 100 \div 80 = 1.25$
これらを合計すると、カイ二乗値 $\chi^2 = 5.0 + 1.25 + 5.0 + 1.25 = \mathbf{12.5}$ となります。自由度は $(2-1) \times (2-1) = \mathbf{1}$ です。
ステップ3:p値の見方と有意判定
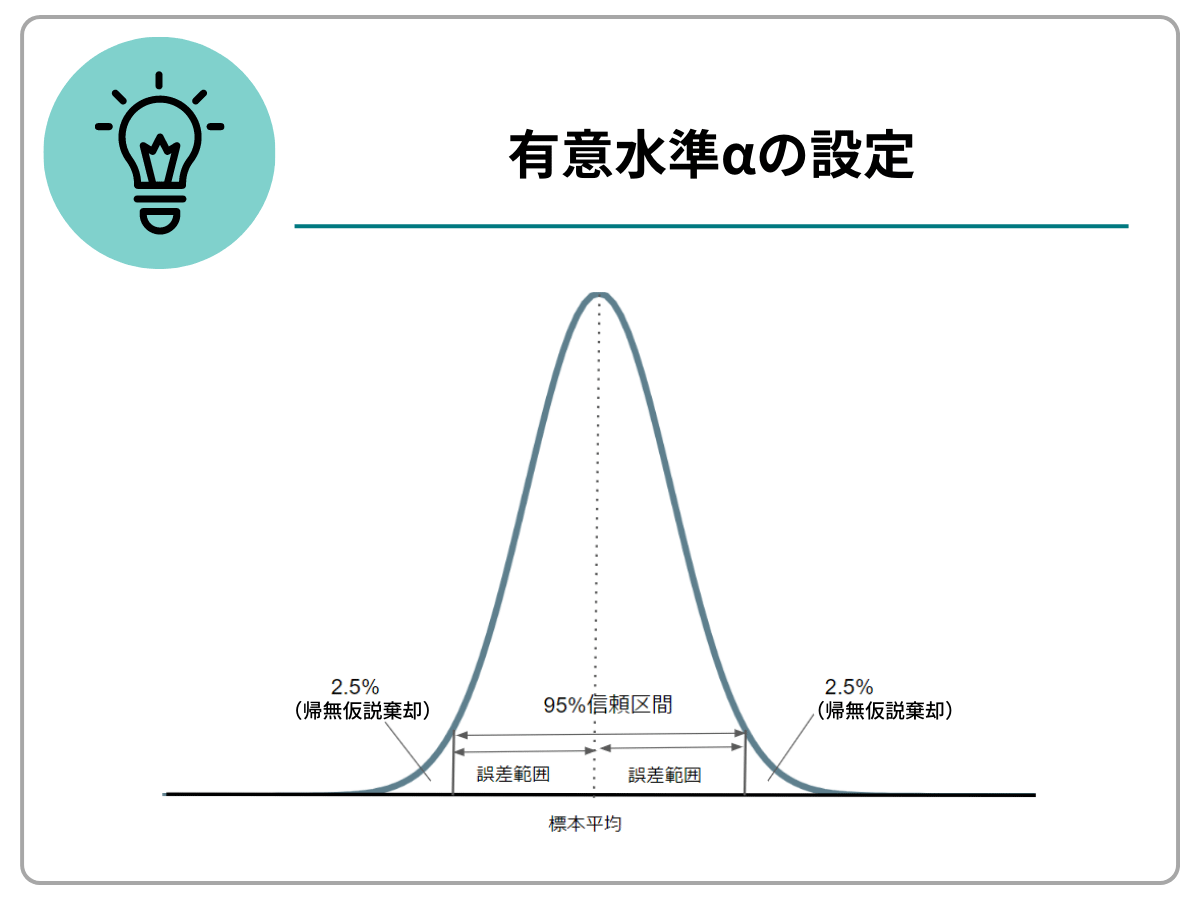
自由度1における有意水準5%(0.05)の境界値(カイ二乗分布表の基準値)は3.84です。今回の計算値「12.5」は基準値を大きく超えているため、p値は0.001(0.1%)未満となり、「メルマガの種類によってクリック率に統計的に有意な差がある」と断定できます。
【ツール別実装】エクセル関数とPythonによる最速計算マニュアル
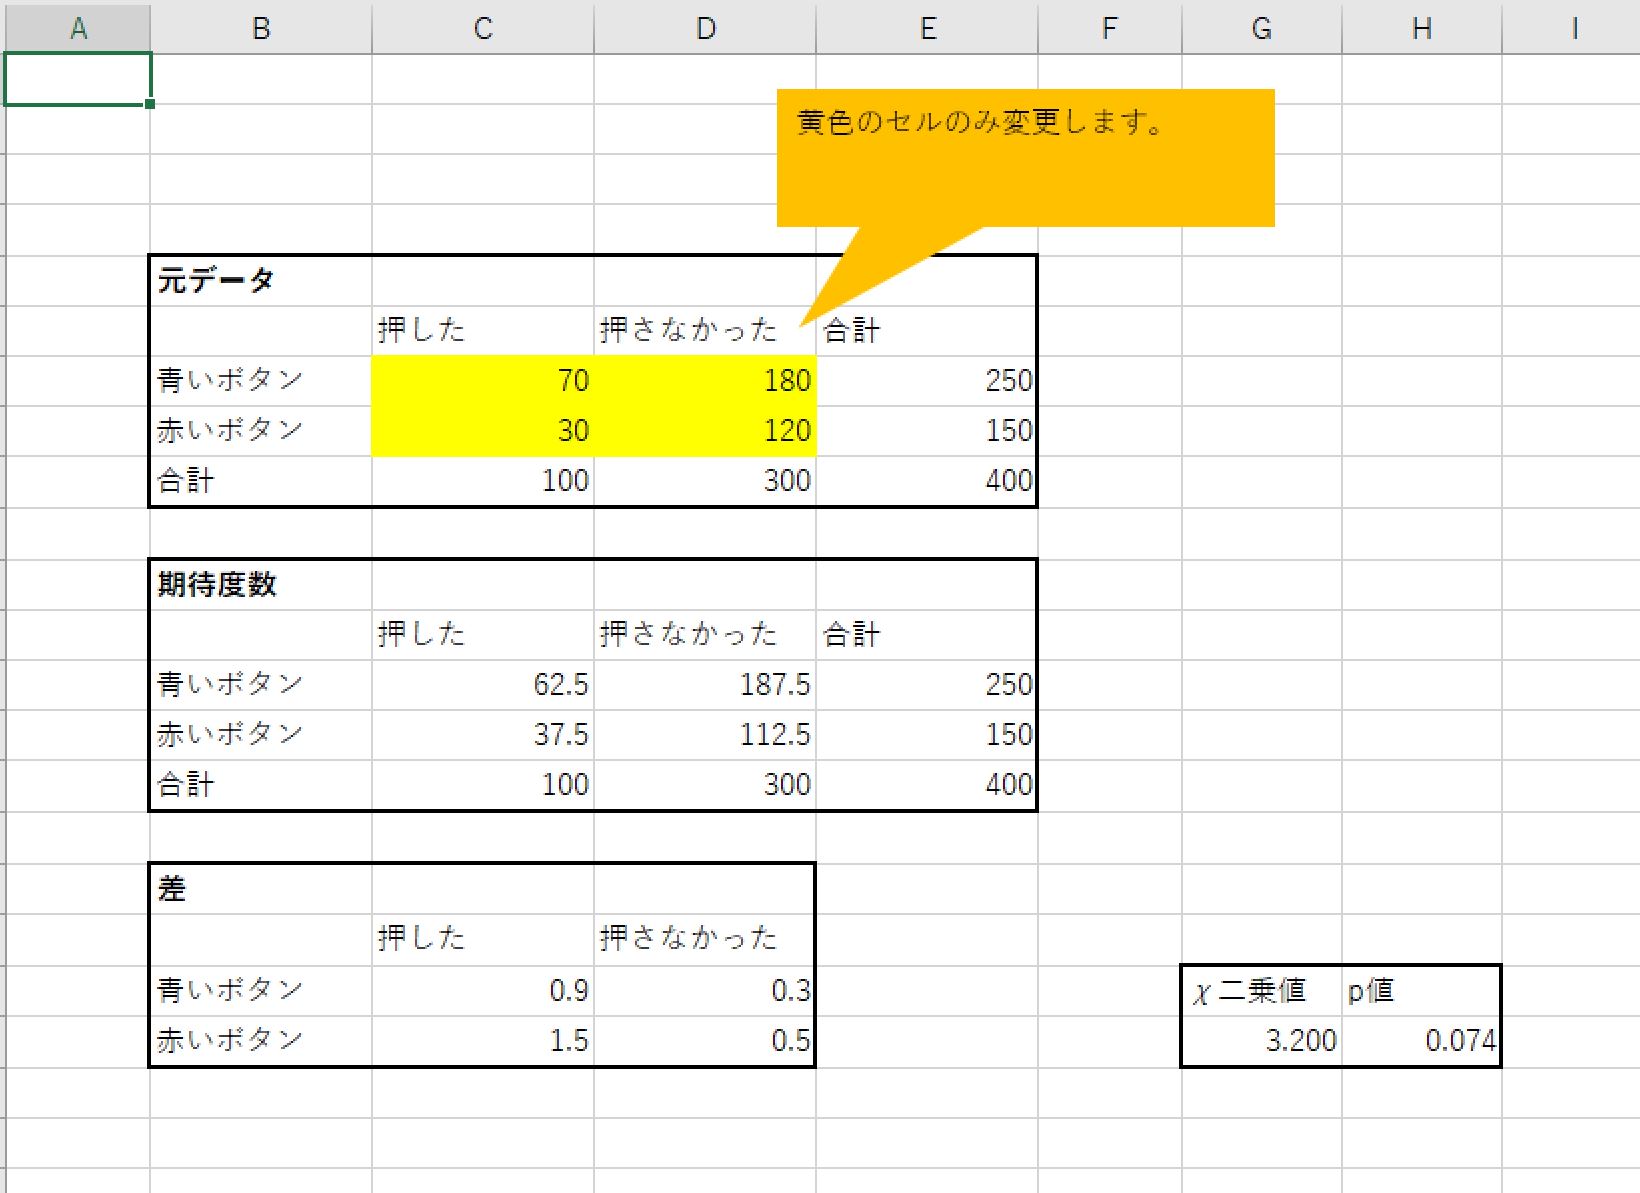
実務において複雑な数式を手計算する必要はありません。日常的な集計ではエクセル、大規模データや自動化パイプラインではPythonを活用するのがスタンダードです。
1. エクセル(Excel)での実践計算
エクセルにはカイ二乗検定専用の関数が用意されており、観測データと期待度数のセル範囲を指定するだけで即座にp値が出力されます。
=CHISQ.TEST(実測値の範囲, 期待度数の範囲)
※旧バージョンのExcel互換関数 =CHITEST(...) でも同様の計算が可能です。返される戻り値は「p値そのもの」であるため、セル内の数値が 0.05未満であれば「5%水準で有意差あり」 と一発で判断できます。
2. Python(SciPyライブラリ)による実装コード
データサイエンス現場では scipy.stats.chi2_contingency を用いることで、クロス集計表(2次元配列)を渡すだけで「カイ二乗値」「p値」「自由度」「期待度数配列」をすべて自動計算できます。
import numpy as np from scipy.stats import chi2_contingency # [[メルマガA_クリックあり, メルマガA_なし], [メルマガB_クリックあり, メルマガB_なし]] observed = np.array([[30, 70], [10, 90]]) # カイ二乗検定の実行(イエーツの補正を適用しない場合は correction=False) chi2, p_value, dof, expected = chi2_contingency(observed, correction=False) print(f"カイ二乗値: {chi2:.4f}") print(f"p値: {p_value:.6f}") print(f"自由度: {dof}") print("期待度数:\n", expected) 一般に知られていない盲点とネットの誤解|「有意差なし」の真相
SNSや知恵袋、社内報告書などで最も多く見受けられる致命的なミスが、「p値が0.05を超えた=施策に効果がなかった(2つの変数に関連はなかった)」と結論づけてしまうことです。
誤解1:「有意差なし」は「差がないことの証明」ではない
統計的検定における「p値 > 0.05(帰無仮説を棄却できない)」は、あくまで「現在のデータ量では、差があるともないとも断定できない(白黒つかない保留状態)」を意味しているに過ぎません。差が微小である場合や、後述するサンプルサイズ不足の場合、実際には差が存在していても検定力不足で有意差が出ないケース(第2種の過誤)が多発します。
誤解2:サンプルサイズが小さすぎる(または大きすぎる)罠
カイ二乗検定を健全に機能させるには、以下の「サンプルサイズの目安基準(コクランの基準)」をクリアしていなければなりません。
- 全体の20%以上のセルで「期待度数」が5未満になっていないこと
- どのセルも「期待度数」が1未満になっていないこと
もしサンプル数が足りず期待度数が5未満のセルが含まれる場合は、カイ二乗検定ではなく「フィッシャーの正確確率検定(Fisher's Exact Test)」を選択するのが統計学的な鉄則です。逆に、サンプル数が数万〜数十万件に達すると、ビジネス上まったく無意味なコンマ数パーセントの極小なブレでもp値が0.000...となり「有意差あり」と出てしまうため、検定統計量だけでなく効果量(Cramer's Vなど)を併せて確認する必要があります。
【プロの結論】おすすめできるケース・慎重になるべきケースの判断基準
- カイ二乗検定を積極的に使うべき状況:
- アンケートの選択肢(「はい/いいえ」「年代別」「購買チャネル」)ごとの偏りを調べたいとき
- 各セルのサンプル数が十分に確保されており(期待度数5以上)、手軽に客観的エビデンスを出したいとき
- 利用を避けるか慎重な代替策を採るべき状況:
- レアケースの集計で、観測数・期待度数が極端に少ないとき(→フィッシャーの正確検定へ切り替え)
- 同一人物の前後の変化(例:セミナー受講前と受講後での意識変化)を比較したいとき(→対応のあるデータのためマクネマー検定[McNemar test]を使用)
【カイ 二乗 検定】に関するよくある質問(FAQ)
Q1:カイ二乗検定とt検定の違いは何ですか?
A1:扱うデータの種類が異なります。カイ二乗検定は「質的データ(カテゴリ・件数・割合)」を対象とするのに対し、t検定は「量的データ(テストの点数、身長、売上金額などの平均値)」の差を比較するために使用します。
Q2:$2 \times 2$の分割表で「イエーツの補正(連続性補正)」は使うべきですか?
A2:自由度1のカイ二乗検定では、離散値を連続分布で近似するズレを補正する「イエーツの補正」が適用されることがあります。ただし、近年は保守的すぎて有意差が出にくくなる(過度な安全策)という批判もあり、サンプル数が十分に大きければ補正なし、サンプル数が小さければフィッシャーの正確検定を用いるアプローチが主流です。
Q3:エクセルのCHISQ.TESTでエラーが出る主な原因は何ですか?
A3:最も多い原因は「実測値のセル範囲」と「期待度数のセル範囲」の行数・列数が一致していないことです。また、セル内に文字列や空白、負の数値が含まれている場合もエラー(#VALUE!や#NUM!)の原因になります。
まとめ:今後の動向と失敗しないための判断基準
ビッグデータやAI活用が急速に進展する現代においても、施策の効果判定やリサーチ結果の妥当性評価においてカイ二乗検定が持つ普遍的な価値は揺らぎません。ダッシュボードに表示されたパーセンテージの差だけに一喜一憂するのではなく、カイ二乗検定を用いて「統計的な再現性があるのか」を検証する姿勢こそが、データドリブンな意思決定の第一歩です。
分析を実施する際は、まずデータの前提条件(クロス表の各セルの期待度数が5以上あるか)を確認し、目的に応じてエクセル関数やPythonを使い分けましょう。そして「有意差なし」が出た際も短絡的な結論を避け、サンプルサイズやビジネス上の文脈を多面的に読み解くことが、分析の現場で最も求められるリテラシーです。 (出典: カイ 二乗 検定(Yahoo!ニュース))
最新のトレンドや話題のニュースをわかりやすく解説するWebライターです。読者の皆様に役立つ情報を日々お届けしています。
