バイナリデータとは?テキストとの違いや仕組みを完全図解
パソコンやスマートフォンでファイルを開こうとした際、画面一面に意味不明な記号や文字の羅列が広がり、困惑した経験を持つ方は少なくありません。ITの世界で日常的に扱われるデータは、大きく分けると「テキストデータ」と「バイナリデータ」の2種類に分類されます。しかし、その根本的なメカニズムや役割の違いを正確に把握している現場担当者は意外なほど限られています。
デジタル社会におけるあらゆる通信、アプリケーション、マルチメディアコンテンツの根幹を支えているのがバイナリデータです。本記事では、IT現場の実態調査や最新の開発動向を踏まえ、バイナリデータの基礎構造からテキストとの決定的な違い、解析ツールの選び方、プログラミングでの実践的な処理手順まで、網羅的に深層解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:バイナリデータはコンピュータが直接解釈できる「0と1」の連続体であり、画像・音声・実行ファイルなどの基盤。
- 要点2:テキストデータとの最大の違いは「文字コードへの直結性」にあり、メモ帳等で開くと制御文字等が誤解釈されて文字化けが発生する。
- 要点3:データ解析にはバイナリエディタやBase64変換が必須であり、適切な取り扱いがシステムトラブルやデータ破損を未然に防ぐ。
【基礎解剖】バイナリデータとは一体何?0と1で構成される仕組み
バイナリ(Binary)という言葉は、本来「2進数」や「2つの要素から成る」という意味を持ちます。コンピュータの内部では、すべての情報が電圧の高低(ONとOFF)という物理的な電気信号によって処理されています。この2つの状態を数値として表現したものが「0」と「1」であり、これを連ねて構成されたデジタルデータ全般を「バイナリデータ」と呼びます。
情報の最小単位は「ビット(bit)」と呼ばれ、1ビットで「0」か「1」の2通りの状態を表します。このビットを8つ束ねたものが「バイト(Byte)」であり、1バイト(8ビット)=2の8乗(256通り)の情報を表現できます。現代のあらゆるファイルは、このバイト単位の膨大な集積によって成り立っています。
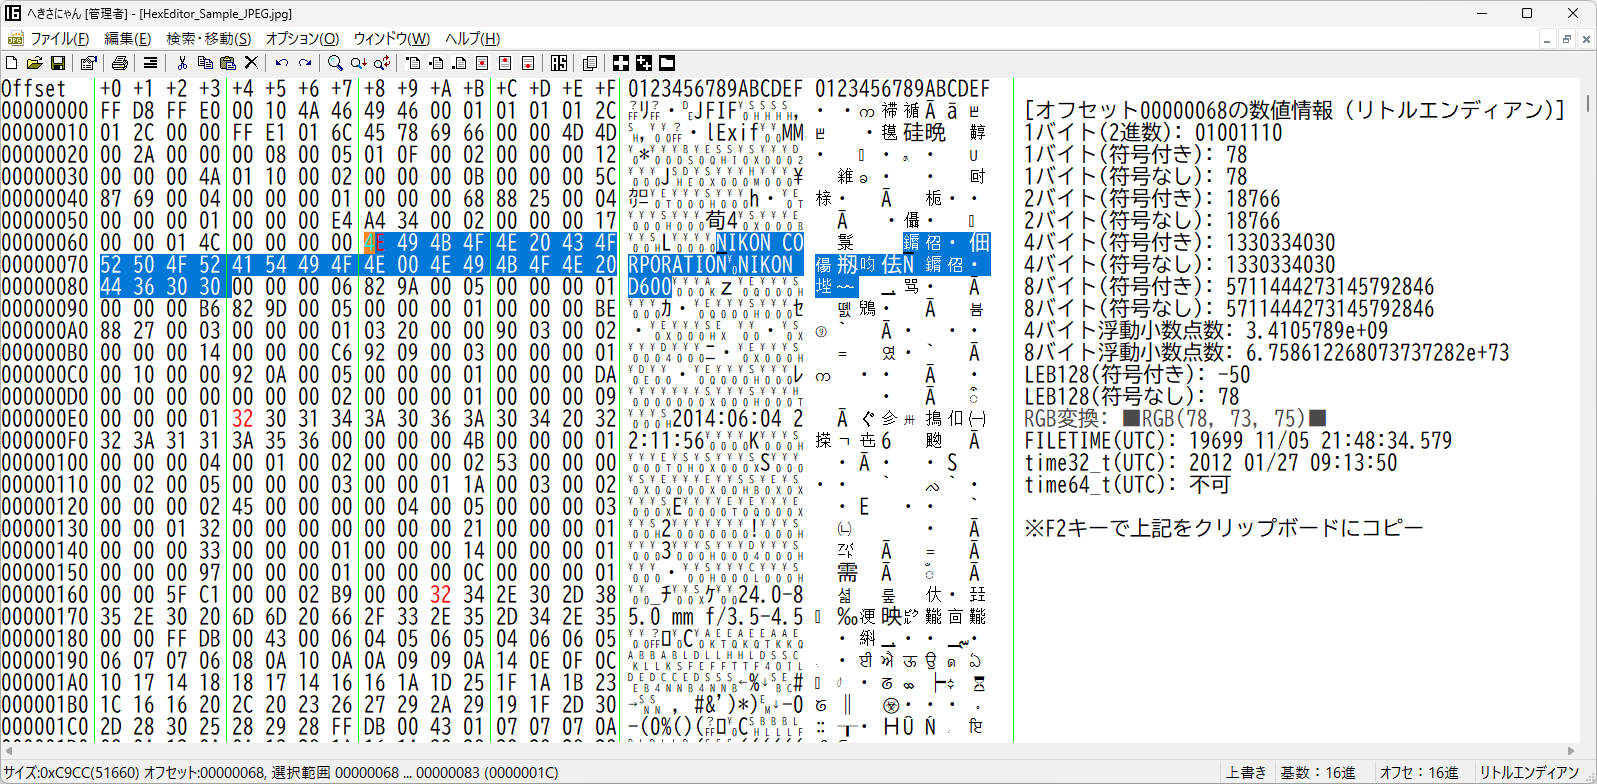
人間がバイナリデータをそのまま確認しようとすると、「01001000 01100101...」といった長大な数値の列になり、視覚的な認識が極めて困難です。そのため、開発現場や解析作業では、2進数4桁分を1桁でコンパクトに表記できる16進数(0〜9およびA〜F)の仕組みを用いてデータを表現するのが国際的な標準規格となっています。
テキストデータとの決定的な違い|なぜ人間が読むと文字化けするのか
データ構造を理解する上で最も重要な比較対象がテキストデータです。どちらも根本は「0と1」のビット列ですが、その構造設計の思想とフォーマットに決定的な差異が存在します。
| 比較項目 | バイナリデータ | テキストデータ | 現場における見解・注意点 |
|---|---|---|---|
| 主要な用途 | 画像、音声、動画、プログラム実行ファイル、圧縮ファイル | ソースコード、設定ファイル(JSON/YAML)、メモ帳文書 | 用途に応じたファイル形式の厳格な切り分けが不可欠 |
| 可読性(人間視点) | 極めて低い(専用のデコーダやエディタなしでは解読不可) | 極めて高い(標準のテキストエディタで即座に読める) | バイナリを通常のエディタで上書き保存すると破損リスク大 |
| データ構造 | ヘッダ部+メタデータ+データ本体(規格ごとの独自定義) | 文字コード(UTF-8, Shift_JISなど)に基づく文字の連続 | バイナリはバイト単位のパディングや圧縮を伴うため容量効率が高い |
| 改行コードの扱い | 改行という概念はなく、単なる1バイトの数値(0x0Aなど)として処理 | 行の終端を明示(CRLF / LF)して改行として表示 | 通信時の自動改行変換(CRLF変換)によるバイナリ破壊に注意 |
メモ帳などで画像やZIPファイルを開いた際に「文字化け」が起きる理由は非常にシンプルです。テキストエディタは、読み込んだバイト列を無理やり文字コード対応表(UTF-8など)に当てはめて表示しようとするためです。たとえば、画像の色情報を示す「0x00」や「0xFF」といった数値は、文字コード上では制御文字や未定義コードに該当するため、画面上に「」や意味不明な記号として出力されてしまいます。
【実態検証】代表的なバイナリファイル形式と内部構造の詳細
私たちが日常的に利用しているファイルの大部分はバイナリ形式です。画像、音声、実行ファイルをはじめとする代表的な拡張子とその特性を整理すると、以下のようになります。
- 画像ファイル(.png / .jpg / .webp / .gif):ピクセルの色彩情報や圧縮アルゴリズム、EXIF情報(撮影日時や位置情報)がバイナリ形式で構造化されています。
- 音声・動画ファイル(.mp3 / .wav / .mp4 / .mkv):サンプリングレートやフレームレート、波形データ、メタ情報が特定のコンテナ規格に沿って格納されています。
- 実行ファイル・ライブラリ(.exe / .bin / .dll / .so):CPUが直接解釈して実行する機械語命令セットとメモリマップが展開されています。
- アーカイブ・ドキュメント(.zip / .pdf / .docx):一見テキストに見えるWordやExcelファイルも、内部構造はXMLをバイナリ圧縮したZIPアーカイブです。
バイナリデータの構造は、先頭に位置する「ファイルヘッダ(マジックナンバー)」、データ属性を定義する「メタデータ部」、そして実際の「コンテンツ本体(ペイロード)」で構成されています。たとえばPNGファイルであれば、先頭の8バイトが必ず「89 50 4E 47 0D 0A 1A 0A」という固有のシグネチャから始まります。OSやアプリケーションはこのシグネチャを検知することで、拡張子が偽装されていても正確なファイルタイプを特定できます。

バイナリデータの中身を見る方法|おすすめエディタとPython処理
バイナリデータの解析やリバースエンジニアリング、デバッグ作業には、専用のバイナリエディタが不可欠です。現場エンジニアの間で高い評価を得ている代表的なツールを用途別に紹介します。
- Stirling(スターリング):Windows環境で長年愛用されている軽量・高機能な定番エディタ。構造体定義や差分比較に強みがあります。
- HxD:大容量ファイルでも動作が極めて軽快で、RAMメモリの直接編集やディスク解析にも対応した無料の万能ツール。
- VS Code(Hex Editor拡張機能):開発環境を統合したいエンジニアに最適。エディタ内でシームレスに16進数ビューアを展開可能。
- Ghidra / IDA Pro:実行ファイルの逆コンパイルやセキュリティ脆弱性診断を行うプロ向けの高度解析プラットフォーム。
また、データ分析や自動化処理を行う現場では、Pythonによるバイナリデータ読み込みが標準的な手法となっています。組み込み関数のopen()でモードに'rb'(Read Binary)を指定することで、ファイル破損を招くことなく純粋なバイト列(bytesオブジェクト)としてデータをメモリ上に展開できます。
さらに、Web APIやメール送信など「テキストしか通さないプロトコル」を介してバイナリを送受信する際には、Base64エンコードが標準技術として利用されます。これはバイナリの6ビットごとに英数字(A-Z, a-z, 0-9)と「+」「/」の合計64文字へ変換するアルゴリズムであり、通信経路での文字化けやデータ欠落を完全に防止する役割を果たしています。
一般に知られていない盲点とネットの誤解
Web上の技術フォーラムやQ&Aサイトでは、バイナリデータに関して誤った認識が散見されます。特に多い誤解と現場の真実は以下の通りです。
第一の誤解は、「バイナリファイルはすべて暗号化されている」という思い込みです。バイナリデータは人間が直接読めない形式で並んでいるだけであり、暗号化(Encryption)とは根本的に異なります。適切なパーサーやエディタを用いれば、誰でも構造を解析して平文の文字列やパラメータを抽出できます。セキュリティ担保のためには、バイナリ化とは別にAESなどの暗号化アルゴリズムを適用しなければなりません。
第二の誤解は、「テキストファイルをバイナリモードで開くと壊れる」という説です。実際には、テキストファイルをバイナリとして読み込んでもデータ自体は一切破損しません。逆のパターン、すなわちバイナリファイルをテキストエディタで開き、意図しない改行コード変換や自動保存を行ってしまうことこそが、ファイルの先頭シグネチャを破壊し、開けなくなる主原因です。
【プロの結論】バイナリ編集・解析に取り組むべき基準と注意点
システム開発やデータ復旧の現場において、バイナリデータを直接操作するアプローチは強力な武器となる一方で、重大なリスクも孕んでいます。取り扱いに関する判断基準は以下の通りです。
- バイナリ解析・編集を推奨するケース:独自フォーマットの通信プロトコル解析、破損ファイルのヘッダ修復、組み込み機器のファームウェア解析、パフォーマンス限界を追求する超高速データシリアライズ処理。
- 直接操作を避けるべきケース:一般的なWebアプリケーションの業務ロジック開発、保守性を重視するデータ連携(JSONやProtocol Buffersなどの標準スキーマを使用すべき場面)。
バイナリ編集を行う際は、必ず「元ファイルのバックアップ取得」を徹底し、1バイトのズレがファイル全体のオフセットを狂わせる危険性を常に念頭に置くことが、プロのエンジニアとしての鉄則です。

【バイナリ データ と は】に関するよくある質問(FAQ)
Q1:バイナリデータを普通のテキストエディタで編集して保存するとどうなりますか?
A1:テキストエディタが解釈できないバイト列を別の文字に置き換えたり、改行コードを自動変換したりするため、ファイルの構造が破壊されて二度と開けなくなる可能性が極めて高くなります。編集には必ずバイナリエディタを使用してください。
Q2:Base64に変換するとファイルサイズが大きくなるのはなぜですか?
A2:Base64は3バイト(24ビット)のバイナリデータを4文字(4バイト=32ビット)のテキストに変換するため、データ容量が計算上約1.33倍(約33%増加)に肥大化します。
Q3:Pythonでバイナリを扱う際、structモジュールを使うメリットは何ですか?
A3:structモジュールを使用すると、C言語の構造体のように「先頭4バイトが整数型、続く2バイトが浮動小数点型」といったバイト列のパッキング・アンパッキングを極めて正確かつ高速に処理できます。
まとめ:今後の動向と失敗しないための判断基準
AIやIoT、エッジコンピューティングが急速に普及する現在、送受信されるデータ量は爆発的に増加しています。テキスト形式の柔軟性が好まれる一方で、通信帯域とストレージ容量を最小限に抑え、処理遅延を極小化するバイナリプロトコルの重要性は一段と高まっています。
データの根底にある「0と1」の構造やバイト配列のルールを正しく理解しておくことは、予期せぬ文字化けやファイル破損のトラブルを未然に防ぎ、高効率なシステム設計を実現するための不可欠な素養です。ツールの適切な選択とリスク管理を徹底し、デジタルデータの真価を引き出してください。 (出典: バイナリ データ と は(Yahoo!ニュース))
SEOライティングとマーケティング戦略の専門家。分かりやすい解説記事で定評があります。
