ノンパラメトリック検定とは?違いや選び方・使い分けを徹底解説
データ分析や臨床研究、マーケティングの現場で多くの担当者が直面するのが、「このデータにt検定を使ってよいのか、それともノンパラメトリック検定を選ぶべきか」という判断の壁です。データの前提条件を見落としたまま検定を進めてしまうと、本来有意ではない差を有意と判定したり、逆に見逃してしまったりするリスクを抱えることになります。
統計解析の精度を高めるためには、データの分布や尺度水準に応じた正しい手法の選定が欠かせません。本稿では、パラメトリック検定との根本的な違いをはじめ、正規性の見極め方、主要な検定手法の使い分けルール、そして実際の解析ソフトでの実行手順まで、現場で即座に役立つ実践的な知識を体系的に解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:母集団の正規分布を前提とせず、外れ値が多いデータや順位尺度データにはノンパラメトリック検定を適用する。
- 要点2:2群比較のマン・ホイットニーのU検定、3群以上のクラスカル・ウォリス検定など、パラメトリック手法と明確な対応関係が存在する。
- 要点3:サンプルサイズやシャピロ・ウィルク検定の結果を基に判断し、EZRなどのツールを活用して正確な選定フローを実行することが不可欠。
【基礎知識】ノンパラメトリック検定とは?パラメトリック検定との決定的な違い
統計学的仮説検定は、大きくパラメトリック検定とノンパラメトリック検定の2つに分類されます。この2つの最も決定的な違いは、「母集団の分布に特定の仮定(主に正規分布)を置くかどうか」という点にあります。
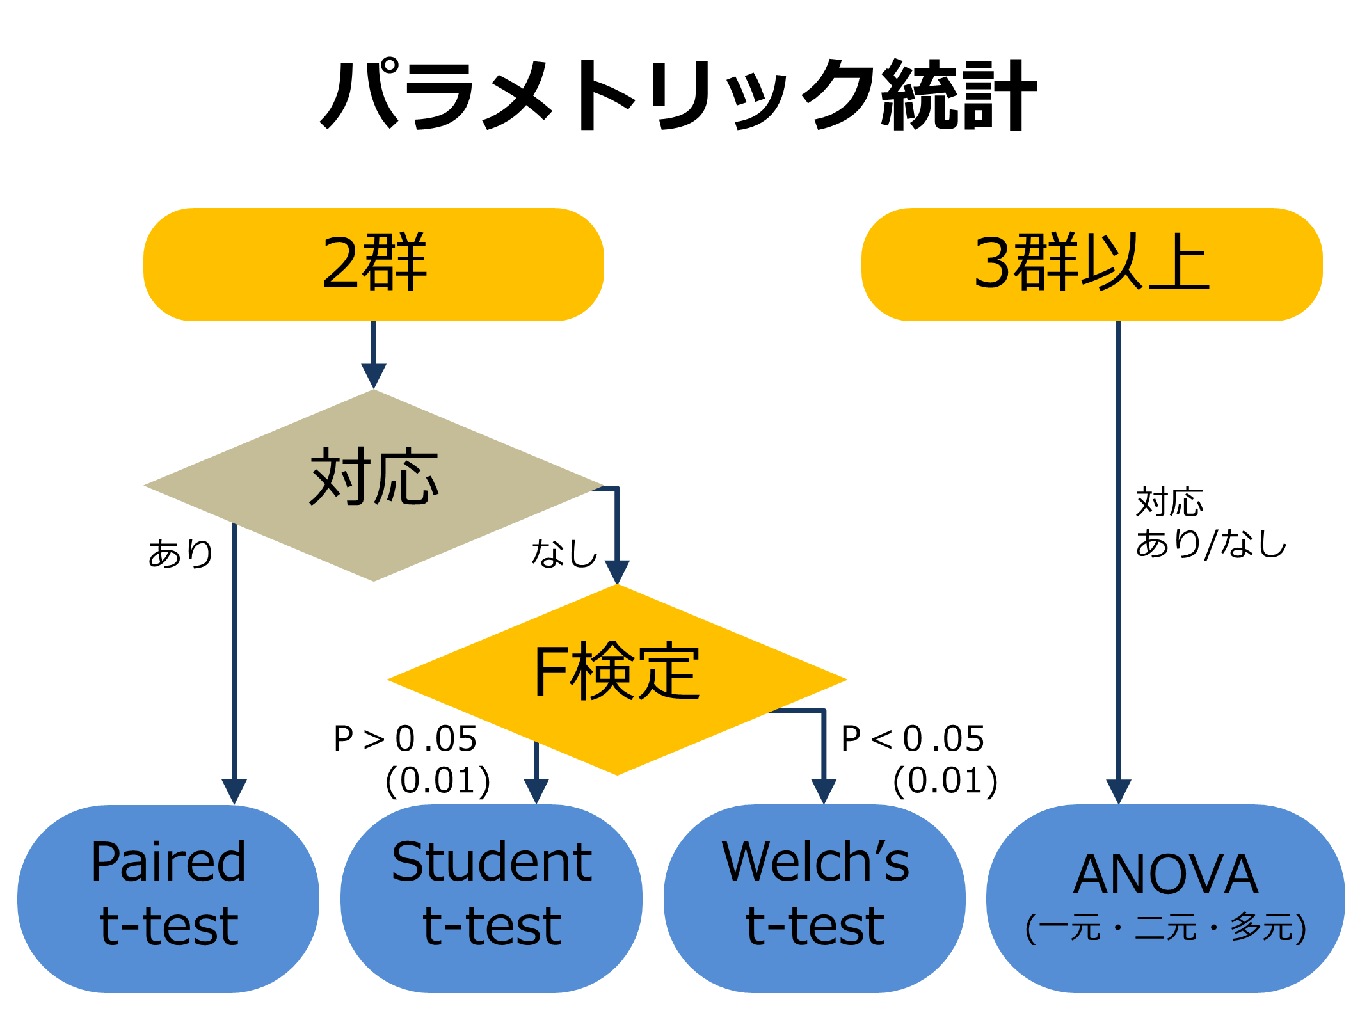
パラメトリック検定は、データが正規分布に従っていることを前提とし、データの「平均値」や「分散」を用いて母集団の性質を推測します。代表例がStudentのt検定や分散分析(ANOVA)です。これらはデータ全体の情報を余すところなく利用するため、前提条件を満たしていれば非常に高い統計的検出力を発揮します。
一方のノンパラメトリック検定は、母集団の分布に特定の確率分布を仮定しません。データの数値をそのまま計算に使うのではなく、数値を小さい順に並べ替えた「順位(ランク)」に変換して検定を行います。そのため、著しい外れ値が含まれる場合や、左右非対称に歪んだ分布を持つデータであっても、結果が歪められにくい頑健(ロバスト)な性質を持ちます。
要約統計量の扱いにおいても違いが現れます。パラメトリック検定が平均値と標準偏差を指標にするのに対し、ノンパラメトリック検定は実質的に順位スコアや中央値の検定(あるいは分布そのものの位置の差)を評価するため、報告時には中央値や四分位範囲(IQR)を併記するのが基本作法です。
また、扱うデータの尺度水準も判断の軸になります。身長や体重のような「間隔尺度・比率尺度(連続変数)」だけでなく、アンケートの満足度(5段階評価)や疾患の重症度スコアのような「順位尺度(順序カテゴリカルデータ)」に対しては、原則としてノンパラメトリック検定を選択するのが妥当です。
いつ使うべき?正規性の検定とサンプルサイズの判断基準
解析を進める際、どちらの手法を選択すべきか迷ったときは、明確な判定ステップを踏む必要があります。選定の核となるのが正規性の検定とサンプルサイズ 基準の確認です。
連続変数のデータを手に入れたら、まずはヒストグラムやQ-Qプロットを作成して視覚的に分布の歪みを確認します。その上で、統計的な検定としてシャピロ・ウィルク検定(Shapiro-Wilk test)やコルモゴロフ・スミルノフ検定を実施します。一般的には、標本サイズが数十から数百程度の実務データにおいて、シャピロ・ウィルク検定の検出力が高く推奨されています。この検定でp値が有意水準(例:0.05)を下回った場合、「データが正規分布に従っているとは言えない」と判断し、ノンパラメトリック検定へ進むのが定石です。
次に考慮すべきはサンプルサイズです。各群のサンプルサイズが極端に小さい場合(例:nが10未満など)、正規性の検定を行っても検出力が不足し、非正規性を見落とす危険性が高まります。そのため、極小標本では最初から安全側に倒してノンパラメトリック手法を採用するケースが臨床研究や製品テストなどで多く見られます。
逆に、中心極限定理により、各群のサンプルサイズが十分に大きい場合(一般に各群n=30〜50以上が目安)は、元のデータ分布が多少歪んでいても標本平均の分布は正規分布に近づきます。ただし、強い外れ値が存在する場合やデータ自体が順位尺度である場合は、大規模サンプルであってもノンパラメトリック検定を用いるのが適切です。
【一覧表で比較】代表的なノンパラメトリック検定とt検定の使い分け
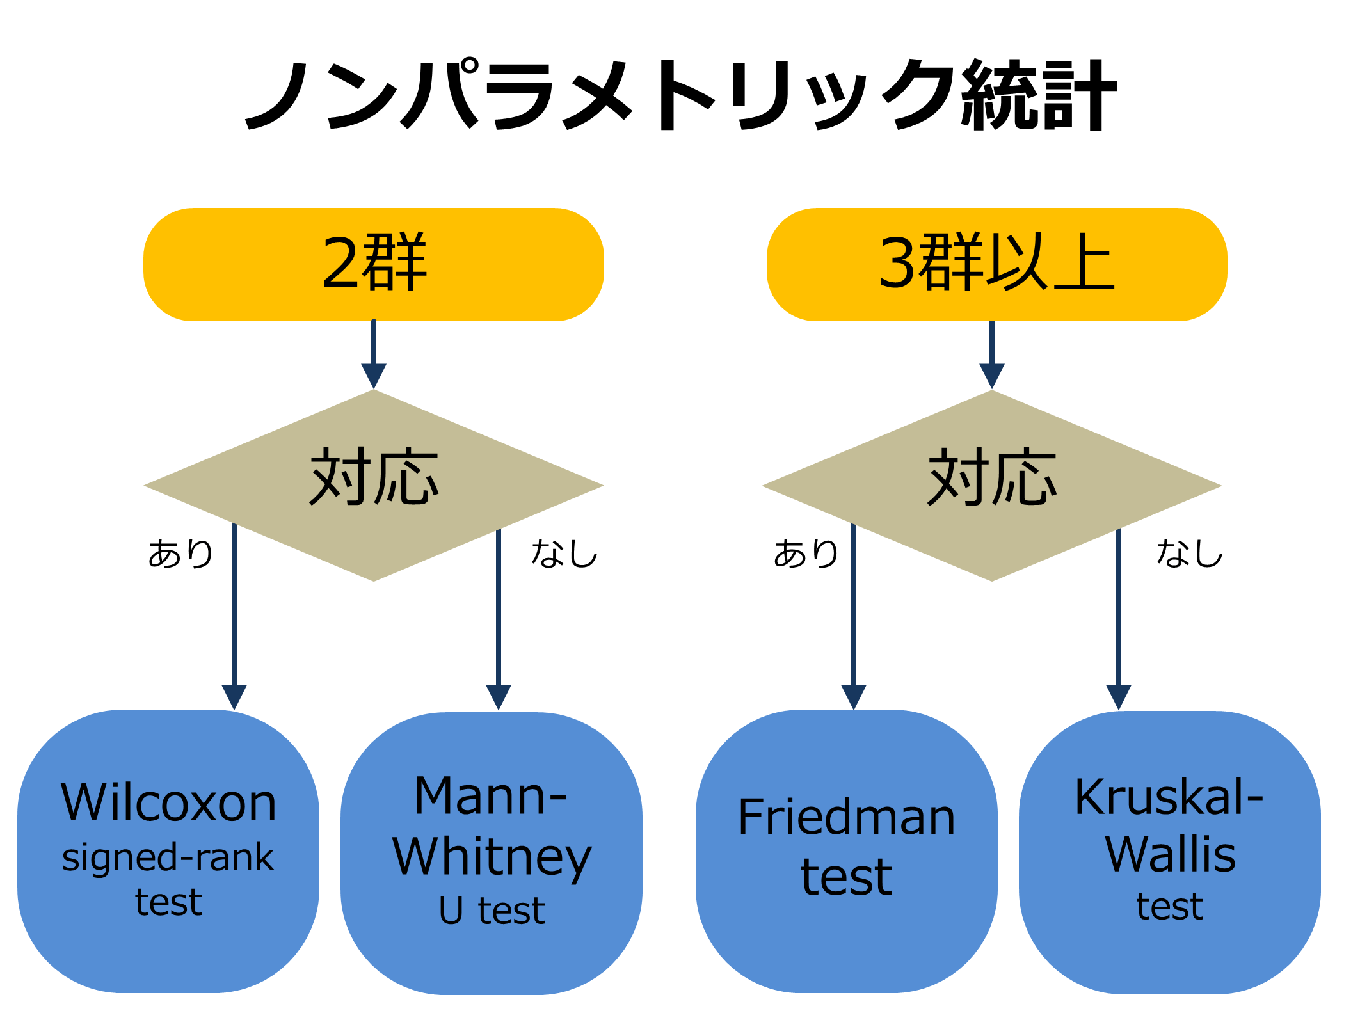
データ解析の現場で頻出する比較シチュエーションに応じて、パラメトリック検定とノンパラメトリック検定には1対1の明確な対応関係が用意されています。
群数やデータの対応関係(ペアデータかどうか)を整理した対応表は以下の通りです。
| 検定の目的・デザイン | パラメトリック検定 | ノンパラメトリック検定 |
|---|---|---|
| 対応のない2群の比較 (例:A群とB群の比較) | Studentのt検定 Welchのt検定 | マン・ホイットニーのU検定 (ウィルコクソンの順位和検定) |
| 対応のある2群の比較 (例:投与前後の変化) | 対応のあるt検定 (Paired t-test) | ウィルコクソンの符号付順位検定 |
| 対応のない3群以上の比較 (例:低用量・中用量・高用量) | 一元配置分散分析 (ANOVA) | クラスカル・ウォリス検定 |
| 対応のある3群以上の比較 (例:3時点での繰り返し測定) | 反復測定分散分析 | フリードマン検定 |
最も利用頻度の高い独立2群の比較では、正規分布を満たすならWelchのt検定、非正規や順位尺度ならマン・ホイットニーのU検定を選択します。また、同一被験者の前後比較などペアが存在するデータで非正規の場合は、差の順位と符号を考慮するウィルコクソンの符号付順位検定が標準となります。
3群以上の多群比較において非正規データを取り扱う場合は、クラスカル・ウォリス検定を実行します。そこで群間に有意差が認められた場合は、どの群間に差があるかを特定するためにスティール・ドゥワス法(Steel-Dwass test)やボンフェローニ補正を用いたマン・ホイットニー検定などの多重比較法へ進む設計を組みます。
質的データ・クロス集計における検定手法|カイ二乗検定とフィッシャーの正確確率検定
ノンパラメトリック検定の文脈では、順位データだけでなく、頻度や割合を比較する「名義尺度(カテゴリカルデータ)」の検定手法も頻繁に取り上げられます。特にA/Bテストのクリック率比較や、投薬の有効・無効の比率比較などがこれに該当します。
クロス集計表(分割表)における代表的な検定がカイ二乗検定(独立性の検定)です。カイ二乗検定は観測度数と期待度数のズレを二乗和で評価する手法ですが、標本サイズが小さい場合には近似の精度が著しく低下するという弱点があります。
具体的には、「期待度数が5未満のセルが全体の20%以上を占める場合」や「総サンプル数が極めて少ない場合」には、カイ二乗検定の使用を避け、フィッシャーの正確確率検定(Fisher's exact test)を選択するのが統計学的な鉄則です。フィッシャーの正確確率は超幾何分布を用いて直接確率を計算するため、標本数が少なくても正確なp値を算出できます。現代の統計ソフトであれば計算コストを気にせず実行できるため、小規模な臨床試験やA/Bテストでは最初からフィッシャーの検定を優先指定する設計が一般的です。
【実践】無料統計ソフト「EZR」でノンパラメトリック検定を実行する手順
医療統計や学術研究の現場で圧倒的な支持を集める無料の統計解析環境が、自治医科大学が開発・公開している「EZR(Easy R)」です。Rの高度な解析機能を直感的なGUIメニューから操作でき、ノンパラメトリック検定も数クリックで完結します。
EZRを用いた標準的な解析フローは次の通りです。
まず、データをインポートした段階で正規性を確かめる場合、上部メニューの「統計解析」→「連続変数の解析」→「正規性の検定(Shapiro-Wilk検定)」を選択し、目的の変数を選んで実行します。
正規性が棄却された後の検定実行もシンプルです。
- 対応なし2群の比較:「統計解析」→「ノンパラメトリック検定」→「2群の比較(Mann-WhitneyのU検定)」を選択し、目的変数と群分け変数を指定。
- 対応あり2群の比較:「統計解析」→「ノンパラメトリック検定」→「対応のある2群の比較(Wilcoxonの符号付順位検定)」を選択。
- 多群の比較:「統計解析」→「ノンパラメトリック検定」→「多群の比較(Kruskal-Wallis検定)」を選択。
出力画面には検定統計量(W値やp値など)とともに、各群の中央値や四分位範囲が表示されます。EZRは操作ログがRスクリプトとして保存されるため、研究論文や分析レポートを作成する際の再現性確保にも大きく貢献します。
失敗しないための注意点|検出力の低下と多重比較の落とし穴
「迷ったら安全のためにノンパラメトリック検定を使っておけばよい」という安易な判断には注意が必要です。そこには統計的なトレードオフが存在します。
最大のデメリットは統計的検出力の低下です。データが実際に正規分布を満たしているにもかかわらず、安全策としてノンパラメトリック検定を適用してしまうと、数値を順位情報に圧縮して捨てることになるため、パラメトリック検定(t検定など)に比べて「真の差」を検出する力が約5〜15%程度低下します。その結果、本来存在したはずの効果を見落とす(第2種の過誤を犯す)リスクが生じます。
また、多群比較における多重性の問題も見逃せません。3群以上の比較でクラスカル・ウォリス検定を有意と確認した後、総当たりでマン・ホイットニーのU検定を無補正で繰り返すと、第1種の過誤(偽陽性)の確率が急激に跳ね上がります。必ずスティール・ドゥワス法やボンフェローニ法による有意水準の調整を行わなければなりません。
さらに、マン・ホイットニーのU検定などを「純粋な中央値の差の検定」として解釈するには、「2群の分布の形状(歪み方)が同一である」という前提条件が必要です。分布の形状自体が大きく異なる場合は、中央値の差ではなく「一方の群の値が他方より大きくなりやすい確率」を検定しているという意味合いになる点を正しく把握しておく必要があります。
【ノンパラメトリック検定】に関するよくある質問(FAQ)
Q1:サンプルサイズがn=5程度と非常に少ない場合、必ずノンパラメトリック検定を使うべきですか?
A1:原則としてノンパラメトリック検定の利用が推奨されます。極小標本ではシャピロ・ウィルク検定などの正規性検定自体の検出力が低く、正規分布に従っているかどうかの判定が不可能です。ただし、サンプルサイズがあまりにも小さすぎる場合(例:各群n=3など)は、ノンパラメトリック検定の仕組み上、理論的にp値が0.05を下回らない限界が存在するため、実験計画の段階で最低限必要な標本数を確保しておくことが不可欠です。
Q2:正規性の検定(シャピロ・ウィルク検定)でp > 0.05だった場合、無条件でt検定を選んでよいですか?
A2:検定結果のみを盲信せず、グラフによる可視化を併用してください。サンプルサイズが小さいときは、実際には歪んだ分布であってもp > 0.05(帰無仮説が棄却されない)となるケースが多々あります。ヒストグラムやQ-Qプロットを目視で確認し、明らかな外れ値や歪みがないかを総合的に判断するのが安全です。
Q3:論文やレポートを作成する際、ノンパラメトリック検定の結果はどう記載すべきですか?
A3:パラメトリック検定では「平均値 ± 標準偏差(Mean ± SD)」を記載しますが、ノンパラメトリック検定を採用したデータでは「中央値(四分位範囲)[Median (IQR)]」または「中央値(最小値 - 最大値)」を代表値として記載するのが国際的な標準ルールです。使用した検定手法名(例:Mann-Whitney U test)と正確なp値を併記します。
まとめ:データ特性を見極めて最適な検定を選定しよう
ノンパラメトリック検定は、正規分布の前提が崩れたデータや外れ値を含むデータ、順序尺度データを分析する上で強力な武器となります。パラメトリック検定との違いを正しく理解し、「データの尺度」「分布の形状」「標本サイズ」「対応関係の有無」を順序立てて評価することで、適切な解析手法を導き出すことが可能です。
手元のデータを闇雲に検定にかけるのではなく、まずは分布の可視化と前提条件のチェックからスタートさせましょう。EZRなどの信頼性の高いツールを駆使し、論理的で再現性の高いデータ解析を実現してください。 (出典: ノン パラメトリック 検定(Yahoo!ニュース))
SEOライティングとマーケティング戦略の専門家。分かりやすい解説記事で定評があります。
